每日新闻 › 2026-10-13
AI 会记事了:Meta 新模型主打"记忆"与"专注"
我是智界探索者。
每天3分钟,带你看懂 AI 前沿——智能体、大模型、机器人、AI终端,都发生了什么。
上周(10月6日—10月12日)有5条消息值得花3分钟看完。一句话概括:AI 这周不只是在变强,还在变得更省钱、更能干活。
01|头条:Meta 发布新模型,主打"记性"和"专注"
美东时间10月12日,Meta 一次发了两个模型:Muse Wonder 和更强的 Muse Wonder Full。官方说法是,在部分智能体、编程、知识工作的测试里,已经能跟 Fable 5.1、Opus 5.5、GPT-6 Astra 这些头部模型掰手腕。
这次重点讲了两件事:
主动记忆:它能跨对话记住背景,你下次提新任务,它主动把相关信息翻出来;
持续专注:碰到障碍不是直接放弃,而是换条路再试,并根据新情况调整方案。
在 Meta 内部的 MemoryBench 记性测试里,Muse Wonder 拿到 85.6 分,高于 GPT-6 Astra 的 81.4 和 Opus 5.5 的 81.5。
(来源:Meta 2026年10月12日发布;每日经济新闻2026年10月13日;投资快报转引 Meta 公布的测试数据,2026年10月13日)
想用得订阅:每月 20 美元或 100 美元。扎克伯格把这叫"个人超级智能",还说接下来模型迭代的速度"可能会让人感觉明显加快"。
一句话解读:模型的竞争重点正在换赛道。 从"谁答得更聪明",换成"谁记得住你、谁盯得住活"。这正好是智能体最缺的两块拼图。
02|OpenAI 一口气放出 722 篇数学手稿,数学界吵翻了
10月6日(北京时间10月7日),OpenAI 在 GitHub 上一次性发布 722 篇数学手稿,归入 372 个"结果族",横跨理论计算机科学、数论、几何、数学物理等 17 个领域,部分成果直接附上 Lean 形式化证明——就是让计算机一行一行核对证明对不对。
生产过程也很直白:用同一个还没公开的内部模型,问了大约 4000 道数学问题,平均每个结果只花掉相当于 ChatGPT Pro 三小时的算力。
但争议同样大。OpenAI 自己撤回过 3 篇手稿,理由是存在明显错误;有数学家抱怨研究被抢发,也有人质疑验证方式。普林斯顿高等研究院的几个数学家干脆自己组了独立小组(成员包括 Gowers、Hairer、Witten 等知名数学家),不接受 AI 公司报酬,单独发布对这类成果的建议。
(来源:科技日报2026年10月7日;iThome 2026年10月7日;环球时报2026年10月13日报道)
一句话解读:AI 进科研,已经过了"能不能做"的阶段,进入"怎么验证、谁来买单"的阶段。工具变强之后,流程和规则才是瓶颈。
03|今年诺贝尔物理学奖:AI 在幕后帮了大忙
10月6日,瑞典皇家科学院宣布:2026 年诺贝尔物理学奖授予弗朗西斯·哈尔岑(Francis Halzen,威斯康星大学麦迪逊分校教授),表彰他对"冰立方中微子天文台"的决定性贡献,以及发现具有天体物理起源的高能中微子。奖金 1200 万瑞典克朗。
这个天文台很硬核:在南极冰层里铺开约 1 立方公里的冰体,埋下数千个光学传感器,2011 年建成。中微子几乎穿过一切不留痕,极难捕捉,捕到一次就闪一次光。
而且,AI 在里面有戏份:团队用卷积神经网络,从成千上万次闪光的形态里反推中微子从哪里来、能量多大——这就是把海量杂乱信号变成科学结论的那一步。
(来源:NobelPrize.org 2026年10月6日新闻公报;新华社2026年10月6日;中国科学院相关科普资料)
一句话解读:这个奖本身不是发给 AI 的,但它是"AI 帮人类做发现"的一个标准样本。以后看科学新闻,别只盯结论,也看看背后用了什么工具。
04|算力往两头走:一头进个人电脑,一头换自研芯片
10月7日,微软在旧金山发布 Surface Laptop Ultra,搭载英伟达 RTX Spark 超级芯片,最高 128GB 统一内存,起售价 2599.99 美元(中国区 21988 元起),10月16日发货。官方说法是:本地就能跑超过 1200 亿参数的模型,不一定非要连云端。
配套还有两件事:Windows 上线了 MXC 执行容器,在系统层限制智能体能碰哪些文件、能连哪些网络;Copilot 会在本地模型和云端模型之间按任务自动调度。
10月12日,媒体又报道:微软计划从 2027 年起以吉瓦级规模部署自研 AI 芯片 Maia 300,宣称每兆瓦能处理的词元数比主流 GPU 系统高约 40%。
同一天,英伟达和思科联合推出 USFP 光模块标准,单通道速率 400Gb/s,带宽密度是现有方案的四倍——这是给算力集群修"内部高速路"。
(来源:21世纪经济报道2026年10月8日;每日经济新闻2026年10月13日;英伟达与思科2026年10月12日发布)
一句话解读:AI 的算力正在同时下沉和上移。 下沉到你的桌面(隐私和成本两种考虑),上移到自研芯片和光互联(不想被单一供应商卡脖子)。这条路修好了,用 AI 的单价才会继续降。
05|万亿参数模型,开放下载了
10月6日,法国 Mistral 开放了新模型 Mistral Large 4 的预览,代号很有意思,叫"le Chonk"。硬指标:总参数约 1.05 万亿,能看图(自带 16 亿参数的视觉编码器),上下文 100 万词元。权重承诺在 10 月底开放下载,也就是说——大公司能把它搬进自己的机房跑。
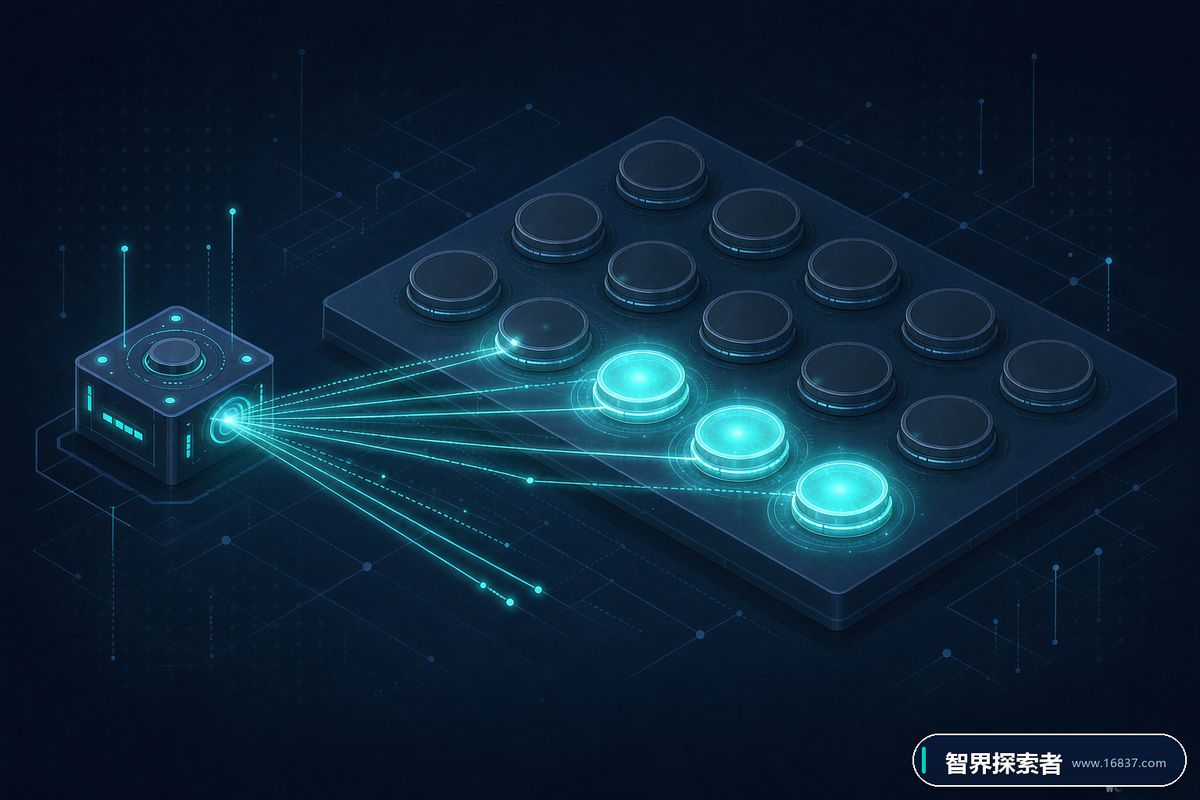
但最值得看的不是"大",而是"每一次只叫醒一小部分":它每个词元只激活约 500 亿参数,大约是总量的 5%。
(来源:Mistral AI 2026年10月6日发布;i-Scoop、etnews 2026年10月8日报道)
一句话解读:"参数大"和"用得起"这两件事,今年第一次能同时成立。 原因就藏在下面这个词里。
彩蛋一句:苹果官宣今晚(美东时间10月13日)办一场名为"Welcome Home"的发布会,据彭博社记者古尔曼爆料,主角是首款智能家居中枢,6 英寸方形屏、由 Siri AI 驱动、能认人识脸。(来源:苹果官方邀请函2026年10月8日;彭博社 Mark Gurman 爆料)
「今日一词」:混合专家(MoE)
上面 Mistral 那台"万亿参数但只激活 5%"的机器,靠的就是这个词。
白话版:模型里请了一屋子的专家,你问一句话,只叫醒最对口的几位,其他人在旁边待着。
对比一下两种做法:
传统做法(稠密模型):问什么,全屋人都得上,算力全开,贵;
混合专家:门口站个"调度员",判断这题该找谁,只叫那几位干活,快又省。
好处很实在:知识可以堆得很大(总参数多),但每次计算量很小(激活参数少)。 这就是为什么今年你会看到"模型越来越重、单价越来越便宜"这两件看似矛盾的事同时发生。
代价也有:所有专家都得装进显存里随时待命。Mistral Large 4 一整套权重按 8 位精度粗算就约 1.05TB,自己部署得靠多机集群——所以真正用得起的,多半是有机房的企业和机构。
(来源:Mistral 官方文档;i-Scoop、Depth Grid 技术分析,2026年10月)
写在最后
AI 这门生意,说到底就三样东西缺一不可:
算力——服务器是地基,没有算力什么都跑不动;
入口——官网、小程序、门店,客户从哪儿找到你;
内容——持续输出的内容,把路人变成客人。
想搭自己的网站、上自己的小程序?进 www.chenclan.cn 了解自助建站与云服务,三样给你配齐。
关注「智界探索者」,周五见。
觉得有用,关注我们,天天有料
微信搜索公众号「陈氏宗亲」·「深圳陈氏」·「互动云」·「智界探索者」
或长按下方二维码识别关注
 陈氏宗亲
 深圳陈氏
 互动云
 智界探索者